
Estanterías vacías o llaves perdidas: por qué tu forma de medir Google Discover no te dice qué arreglar
Si mides Google Discover como casi todos los equipos editoriales, probablemente miras el mismo panel: clics, impresiones, evolución mensual y una comparación con el mes anterior. Con esos datos, la conclusión suele ser rápida, el tráfico sube o baja.
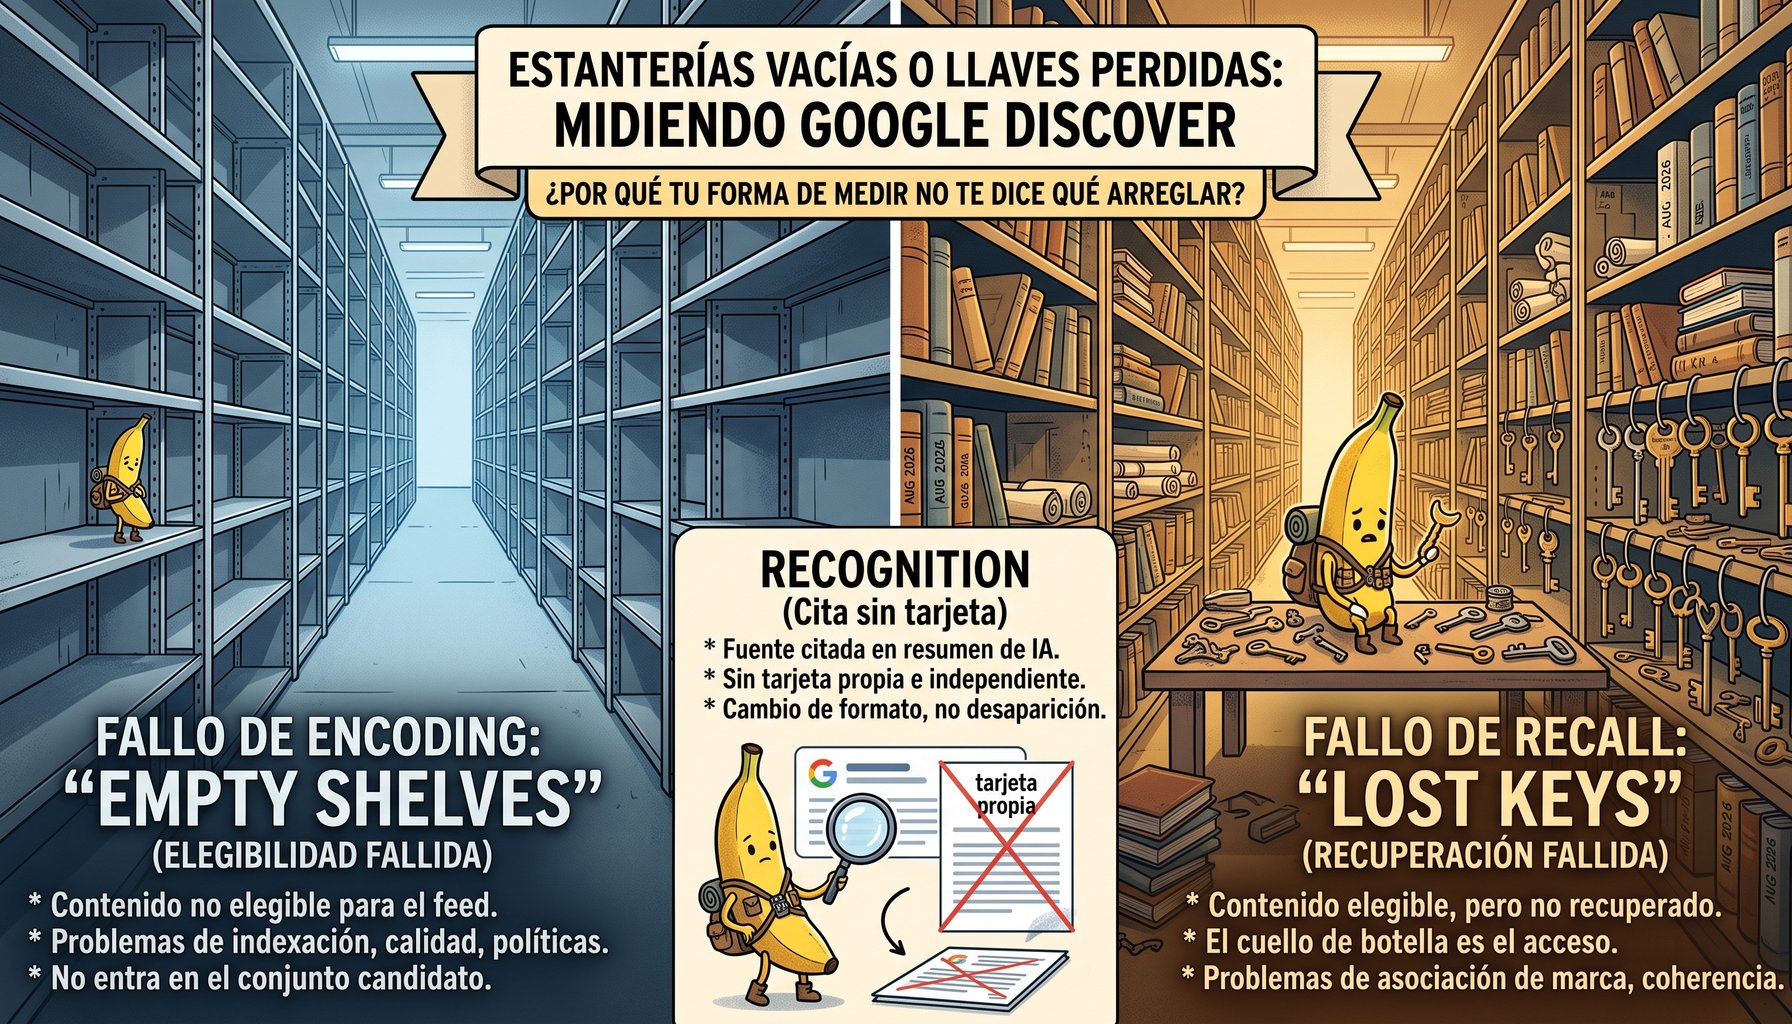
Ese enfoque tiene un problema, convierte en un único síntoma varias causas distintas. Una caída de clics puede deberse a que tu contenido ha dejado de ser elegible para el feed. Puede deberse a que sí sigue siendo elegible, pero no se recupera para los usuarios para los que sería relevante. O puede deberse a que sí aparece, pero no como tarjeta propia, sino como cita dentro de un resumen generado por IA. Son tres problemas diferentes, con soluciones distintas, y sin embargo el informe agregado los presenta como si fueran el mismo.
Un paper reciente de Google Research plantea un problema parecido en otro contexto: la memoria de los modelos de lenguaje. Y aunque no habla directamente de Google Discover, su marco de diagnóstico puede resultar muy útil para mejorar la forma en que medimos la presencia editorial en el feed.
El paper: “Empty Shelves or Lost Keys?”
En agosto de 2026, Nitay Calderon y Gal Yona publicaron en Google Research un trabajo titulado Empty Shelves or Lost Keys? Recall Is the Bottleneck for Parametric Factuality, acompañado de un benchmark abierto llamado WikiProfile, con 2.150 hechos extraídos de Wikipedia.
La pregunta de partida es sencilla: cuando un LLM responde incorrectamente un dato, ¿lo hace porque nunca lo aprendió o porque no consigue recuperar lo que sí estaba almacenado?
La métrica habitual de precisión mezcla ambos casos, pero las causas tienen implicaciones muy distintas. Si el modelo no tiene el hecho representado en sus parámetros, el problema es de aprendizaje. Si lo tiene, pero no lo recupera, el problema es de acceso.
Para separar esas situaciones, los autores proponen un enfoque llamado knowledge profiling, que distingue tres estados:
Encoding: el hecho está representado en los parámetros del modelo.
Recall: el modelo consigue recuperarlo y generarlo sin pistas externas.
Recognition: el modelo identifica el hecho correcto cuando se le presenta entre varias alternativas.
El resultado central es importante. En modelos frontera como Gemini 3 Pro y GPT-5, el encoding está prácticamente saturado: alrededor del 95-98 % de los hechos están codificados. Sin embargo, esos mismos modelos fallan al recuperar directamente entre el 26 % y el 34 % de esos hechos. Con razonamiento activado, el error disminuye, pero no desaparece.
En otras palabras, el cuello de botella no es necesariamente lo que el modelo sabe, sino lo que el modelo puede acceder.
Dos hallazgos secundarios resultan especialmente relevantes para la analogía editorial.
Primero, los hechos menos frecuentes están codificados casi tanto como los populares. La diferencia entre cola larga y cabecera es pequeña en encoding, pero mucho mayor en recall. Esto sugiere que el problema de los temas menos frecuentes no es que estén ausentes del modelo, sino que son más difíciles de recuperar.
Segundo, el razonamiento recupera entre el 40 % y el 65 % de los hechos que están codificados pero no son recuperables de forma directa. Y lo hace precisamente en las áreas donde el recall directo es más débil.
Cómo se traduce eso a Google Discover
Antes de aplicar la analogía, conviene marcar su límite con claridad.
Este paper no estudia Google Discover. No analiza sistemas de recomendación, recuperación de documentos ni páginas web. Mide memoria paramétrica de modelos de lenguaje a libro cerrado. Por tanto, cualquier aplicación a Discover es una analogía metodológica, no una demostración de que el feed interno de Google funciona de esa manera.
Dicho esto, la analogía tiene sentido por una razón concreta, el problema estructural es similar. Un sistema que aparentemente “no sabe” algo puede estar fallando en puntos muy distintos del proceso, y una métrica agregada no permite distinguir cuál es el punto de fallo.
Además, con la incorporación de resúmenes generados por IA en algunas superficies de Discover, la comparación deja de ser solo teórica. Según la cobertura previa sobre el tema, existen escenarios en los que un modelo generativo selecciona y cita fuentes dentro del feed. Si eso ocurre, ya no basta con medir clics sobre tarjetas propias, hay que distinguir entre aparecer como tarjeta, aparecer como cita y no aparecer en absoluto.
En términos operativos, la traducción sería la siguiente:
| Estado del paper | Equivalente en Discover | Qué significa |
|---|---|---|
| Fallo de encoding | Fallo de elegibilidad | Tu contenido no entra en el conjunto candidato: problemas de indexación, políticas, calidad de imagen, señales del medio o condiciones técnicas. |
| Fallo de recall | Fallo de recuperación | Tu contenido es elegible, pero no se recupera para el interés específico del usuario. |
| Recognition sin recall | Citado sin tarjeta | Apareces como fuente o logo dentro de un resumen agrupado, pero no como tarjeta independiente con enlace propio. |
Ese tercer caso es especialmente relevante ahora mismo. Si solo mides clics, un desplazamiento de tarjeta propia a cita dentro de un resumen puede leerse como pérdida de visibilidad. Pero no es necesariamente desaparición, es cambio de formato. Y requiere una respuesta distinta.
Cinco cambios para medir mejor Google Discover
1. Cambia la unidad de análisis: de la URL a la entidad
El movimiento central del paper es dejar de evaluar respuestas sueltas y empezar a perfilar hechos. En un contexto editorial, el equivalente es dejar de puntuar URLs aisladas y empezar a trabajar por entidades, clusters temáticos o ejes de cobertura.
Google Discover no recomienda como si fuera un buscador clásico. No trabaja principalmente a partir de una consulta explícita, sino a partir del interés del usuario. Si tu unidad de análisis es la URL, estás midiendo el resultado de una muestra pequeña y variable. Si tu unidad es la entidad (un tema, un club, una empresa, un regulador, un país, una vertical) puedes plantearte una pregunta mucho más útil: de todas las historias publicadas sobre esta entidad esta semana, ¿en cuántas aparece mi medio?
Eso convierte la medición de un evento puntual en una señal de posición editorial.
2. Recupera el denominador
El informe de Search Console te muestra el numerador: cuántas veces se mostró tu tarjeta, cuántos clics recibiste, cuántas impresiones generaste.
Pero no te muestra el denominador completo: cuántas oportunidades había en tu vertical, cuántas historias compitían por ese interés, cuántos medios cubrían el tema y con qué fuerza.
Esa falta de denominador es una de las razones por las que las variaciones de Discover se viven como un fenómeno impredecible. Si no sabes cuántas oportunidades existían, no puedes distinguir entre una pérdida real de visibilidad y un entorno donde simplemente hubo menos noticias, menos competidores o menos interés general.
El denominador hay que construirlo fuera del panel: volumen de publicación en tu vertical, número de medios que cubren el tema, intensidad de la conversación, relevancia del tema y distribución de formatos. Sin esa capa contextual, la métrica de clics se vuelve difícil de interpretar.
3. Segmenta por popularidad, no solo por rendimiento
Una forma útil de aplicar el marco del paper es dividir tus clusters en cohortes de cabecera y de cola larga. No mires solo los temas que ya funcionan, sino también los temas donde tu cobertura podría tener una posición sostenible aunque sea menos evidente.
El paper sugiere que la diferencia no está tanto en la presencia del hecho como en la facilidad para recuperarlo. En Discover, eso puede traducirse así: si tu tasa de aparición en temas de cabecera es competitiva, pero en temas más específicos o nicho cae muy por debajo de la de otros medios, el problema puede no ser de contenido, sino de asociación de marca con esos temas.
Si ese es el caso, la respuesta no es necesariamente publicar más, sino densificar la relación entre tu medio y esos ejes. Eso puede implicar cobertura sostenida, coherencia de nombres, profundización temática, archivo de calidad, corresponsalías especializadas o una mayor presencia en conversaciones donde tu entidad debería aparecer.
4. Separa share of card de share of citation
No uses una sola métrica para captar la presencia en el feed. Con la llegada de la IA generativa a Google Discover ahora surgen dos métricas diferentes:
Share of card: porcentaje de historias del cluster en las que apareces como tarjeta independiente, con enlace directo a tu contenido.
Share of citation: porcentaje de historias en las que apareces como fuente dentro de un resumen agrupado o como referencia secundaria.
Ambas métricas dicen cosas diferentes.
La primera mide visibilidad accionable: el usuario puede ver tu marca y hacer clic directamente en tu historia. La segunda mide reconocimiento de fuente: tu medio está presente como referencia, pero no necesariamente se le da la tarjeta principal.
Un medio que sube en citación pero baja en tarjeta puede estar experimentando un desplazamiento de formato. No está desapareciendo del todo, pero está perdiendo el formato más visible. Eso merece un diagnóstico propio: autoridad de fuente, reconocimiento editorial, corrobación externa, coherencia de cobertura y fuerza de marca.
5. Mide en modo razonamiento y sin razonamiento
Este es uno de los puntos más útiles del paper y también uno de los menos aplicados.
Si el razonamiento recupera una parte importante de los hechos que están codificados pero no son accesibles de forma directa, entonces la visibilidad de tu medio en superficies conversacionales puede depender del modo en que se le pregunte al modelo.
Una auditoría de visibilidad en IA que mida solo con una pregunta, en un solo modo o en una sola formulación está dando una foto incompleta. Conviene preguntar lo mismo con diferentes enfoques.
Por ejemplo:
Pregunta directa: ¿Qué cubre [tu medio]?
Pregunta inversa: ¿Qué medios cubren [tu vertical] en España?
Pregunta comparativa: ¿Qué medios suelen informar sobre [entidad] en [sector]?
Pregunta de recuperación: ¿Dónde encontraría información reciente sobre [tema]?
Y también conviene variar el modo: con razonamiento simple, sin razonamiento explícito, con contexto breve y con contexto más amplio.
Si tu medio aparece en la pregunta directa pero no en la inversa, o si solo aparece con razonamiento y no sin él, eso no significa que tu marca esté ausente. Puede significar que está codificada, pero de forma frágil. Y ese es un diagnóstico distinto (y, en muchos casos, más recuperable) que la ausencia total.
Qué acción corresponde a cada diagnóstico
No todas las pérdidas de visibilidad en Discover se resuelven de la misma manera. Con este marco, puedes separar mejor las causas.
Si el problema es de elegibilidad
El diagnóstico apunta a factores técnicos, de políticas o de señal del medio.
Posibles causas:
problemas de indexación;
imágenes de baja resolución o mal optimizadas;
cumplimiento incompleto de las directrices de Discover;
señales débiles de fuente o autoría;
contenido que no cumple los requisitos del feed;
cambios de estructura que afectan la presentación de la tarjeta.
Aquí la respuesta es técnica y editorial: mejorar la calidad de la señal, corregir errores de indexación, revisar imágenes, reforzar autoría y comprobar que el contenido cumple las condiciones de elegibilidad.
Si el problema es de recuperación
El diagnóstico apunta a que tu contenido podría ser elegible, pero no se está recuperando para los usuarios interesados.
Posibles causas:
cobertura dispersa
falta de consistencia en el tratamiento de una entidad
ausencia de archivo relevante
baja corrobación externa
asociación débil entre tu medio y ese tema
competencia más fuerte en ese cluster
Aquí la respuesta no es solo publicar más, sino publicar de forma más sostenida y reconocible. Se trata de construir una relación clara entre tu marca y el tema: cobertura regular, profundización, contexto, datos, análisis y presencia en conversaciones donde tu medio debería ser una referencia.
Si el problema es reconocimiento sin tarjeta
El diagnóstico apunta a que tu medio aparece, pero no como tarjeta principal.
Posibles señales:
aumentan las citas dentro de resúmenes agrupados
disminuyen los clics directos a tu historia
tu medio aparece como fuente, pero no como destino
otros medios capturan la tarjeta principal
la audiencia reconoce la cobertura, pero no accede directamente a tu contenido
Aquí la respuesta debe atacar la autoridad de fuente y la relación directa con la audiencia. Puede implicar reforzar la marca, construir comunidad, mejorar la distribución fuera del feed, aumentar la corrobación editorial y hacer más visible la relación entre tu medio y el tema que cubre.
La cautela final
Estamos haciendo una aproximación de un paper de investigación, este marco es prestado. No hay evidencia pública de que Google Discover implemente internamente los tres estados descritos en el paper, ni de que su sistema de recomendación sepa distinguir de forma explícita entre encoding, recall y recognition. Quien afirme que es así, sin mostrar pruebas, seguramente esté extrapolando demasiado las conclusiones del paper.
Lo que sí aporta este enfoque es disciplina de medición. Obliga a hacer preguntas que normalmente no se hacen:
¿Cuál es el denominador real?
¿Estamos midiendo tarjetas o también citaciones?
¿Nuestro problema es de elegibilidad, recuperación o formato?
¿En qué temas estamos perdiendo posición y en cuáles solo cambiamos de superficie?
¿Nuestra marca aparece solo cuando se pregunta de una forma muy específica?
Eso es valioso aunque la analogía con el paper no encaje perfectamente con la arquitectura real de Google.
El trabajo está publicado en arXiv bajo el identificador 2602.14080 y tiene una versión divulgativa en el blog de Google Research. Merece la lectura completa, no solo para entender la memoria de los LLMs, sino también para calibrar cuánto de lo que se está escribiendo sobre él en el sector editorial corresponde realmente al contenido del paper.

